Avoir des données de marché automobile erronées n’est pas seulement un désagrément opérationnel. Cela conduit directement à de mauvaises décisions commerciales : des produits sur- ou sous-évalués, des concurrents mal cernés, des positions de marché mal comprises. Cet article explique les processus et les outils que nous avons mis en place chez Datatorq pour garantir que, lorsqu’un client reçoit des données de notre part, il puisse leur faire confiance, les utiliser immédiatement et prendre des décisions en toute confiance.
Le problème des données automobiles aujourd’hui
Les données automobiles existent en abondance. Configurateurs des constructeurs, listes de prix officielles, brochures, sites tiers — la matière première est partout. Le problème n’est pas la disponibilité. Le problème, c’est la cohérence, la fiabilité et l’utilisabilité.
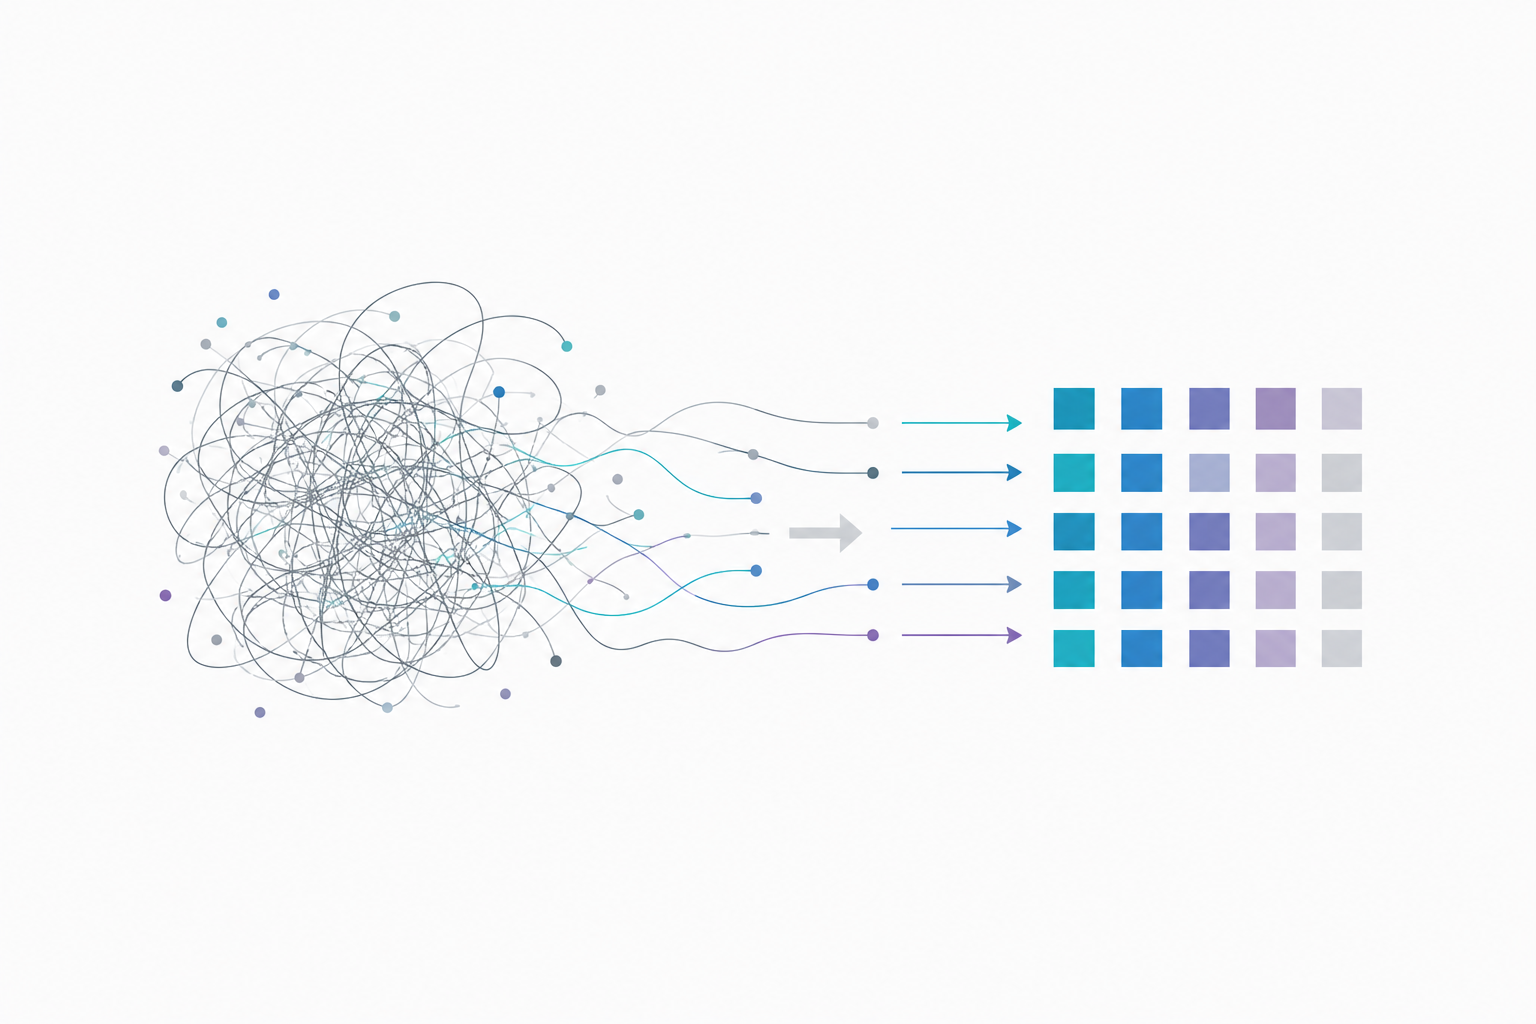
Quiconque a construit un outil de benchmarking concurrentiel, un modèle de prix ou une analyse de Coût Total de Possession (TCO) reconnaîtra le schéma : on passe le premier tiers du projet à réconcilier des incohérences avant que la moindre analyse réelle puisse commencer. Des définitions différentes pour la même donnée. Des valeurs manquantes qui varient selon le marché. Une capacité brute de batterie là où la capacité nette était nécessaire. Des communications constructeur précises dans certains pays et optimistes dans d’autres. Ce ne sont pas des cas particuliers — c’est l’état normal des données automobiles. Notre méthodologie est conçue autour de cette réalité.
Cadrage sur mesure des données automobiles : la précision avant le volume
Chaque projet commence par une phase de cadrage. Nous travaillons avec le client pour définir précisément quelles données sont nécessaires, pour quels marchés et segments, avant que la collecte ne commence. Ce n’est pas un détail mineur du processus. Les bases de données automobiles peuvent compter des centaines de points de données ; un gestionnaire de flotte comparant des fourgons électriques a besoin d’un sous-ensemble fondamentalement différent de celui d’un carrossier exigeant une précision dimensionnelle absolue.
Partir d’un périmètre défini plutôt que d’un jeu de données large signifie que les clients ne paient que pour ce qui est pertinent pour leur question. Cela impose aussi une précision des définitions en amont — s’accorder exactement sur ce que signifie une donnée avant le début de la collecte élimine l’ambiguïté qui, sans bruit, corrompt l’analyse en aval. Le périmètre est le contrat entre nous et le client : rien de redondant, rien qui manque.
Technologie et data science : cohérence et qualité à grande échelle
La collecte est gérée via une application interne propriétaire, conçue spécifiquement pour les données automobiles. Elle guide les analystes à travers un flux de saisie standardisé qui correspond directement à notre schéma de base de données, avec des règles de validation intégrées qui signalent les erreurs au moment de la saisie — avant qu’elles n’atteignent la base de données. Une valeur hors de la plage attendue, un champ obligatoire manquant, une saisie incohérente avec des données associées : tout est signalé immédiatement. Les erreurs sont évitées à la source, et non détectées en aval.
Au-delà de la validation au point de saisie, nous appliquons des méthodes de data science pour surveiller la qualité en continu sur l’ensemble de la base de données. Des contrôles statistiques identifient les valeurs aberrantes, les incohérences entre champs et les schémas qui suggèrent un problème systématique lié à une source ou un marché spécifique. Ces contrôles s’exécutent sur toute la base de données plutôt que sur des enregistrements isolés, ce qui permet de détecter des problèmes qui ne deviennent visibles qu’à grande échelle. Les anomalies signalées sont examinées et résolues avant de pouvoir affecter les livrables des clients.
Validation humaine : quand la technologie seule ne suffit pas
Les constructeurs ne communiquent pas toujours leurs données de façon précise ou cohérente entre les marchés. L’automatisation peut appliquer des règles et détecter des anomalies statistiques — mais elle ne peut pas reconnaître qu’un chiffre paraît invraisemblable au regard de ce que le même constructeur publie ailleurs, ou que la documentation d’un marché est historiquement peu fiable pour une donnée précise. Cela demande un jugement humain formé.
Nos analystes sont formés à questionner les communications des constructeurs plutôt qu’à les enregistrer telles quelles. Lorsque les données d’un marché sont incomplètes ou incertaines, nous les recoupons avec des marchés où nous avons une grande confiance dans les données du même modèle — en comblant les lacunes avec des valeurs vérifiées plutôt que de laisser des trous ou de nous fier à des sources locales douteuses. La standardisation s’appuie sur notre Glossaire de Données : une référence interne qui recense chaque caractéristique de véhicule que nous suivons, définit comment la terminologie propre à chaque constructeur correspond à notre schéma, et garantit que lorsque les clients comparent des équipements entre marques, ils comparent des caractéristiques réellement équivalentes — pas simplement des libellés correspondants qui peuvent décrire des choses différentes.
Exemple réel tiré de nos recherches
Des petits fourgons Stellantis construits sur la même plateforme de base présentent des écarts significatifs selon les marchés européens : l’e-Rifter est documenté avec une capacité brute de 52 kWh au Royaume-Uni et aux Pays-Bas, mais de 54 kWh en France ; l’e-Partner Van est indiqué avec une chimie lithium-ion à 50 kWh en Allemagne et en Italie, tandis que la France et les Pays-Bas affichent du LiFePO à 54 kWh. Un analyste enregistrant ces chiffres au pied de la lettre injecterait ces écarts dans n’importe quel modèle de benchmarking ou de TCO comme s’ils reflétaient de réelles différences entre véhicules.
Lisez notre analyse complète sur les batteries des fourgons électriques →
Livraison : des données opérationnelles dès le premier jour
La livraison s’adapte à l’infrastructure de chaque client : exports structurés, accès API, ou intégration directe dans l’un de nos outils d’analyse. Comme les données ont été cadrées précisément, collectées de façon cohérente et contrôlées à chaque étape, elles arrivent prêtes à l’emploi. Aucune phase de nettoyage. Aucun exercice de réconciliation. Les données fonctionnent dès le premier jour — c’est précisément l’objectif.
Des données fiables sur le marché automobile : le socle de toute décision de prix et de produit
Les méthodes décrites ci-dessus ne sont pas la partie la plus visible de ce que fait Datatorq. Les outils de benchmarking, les modèles de TCO, les études de marché — voilà ce avec quoi les clients interagissent directement. Mais ils ne valent que ce que valent les données véhicules qui les sous-tendent.
Obtenir des données justes — de façon complète, cohérente et vérifiable — c’est ce qui permet aux équipes prix et produit de prendre des décisions qu’elles peuvent assumer. C’est l’exigence que nous nous imposons, sur chaque jeu de données, chaque marché et chaque client avec lequel nous travaillons.
Vous voulez voir comment les données de Datatorq fonctionnent pour votre cas d’usage précis ?